こんにちは、bravesoftのUI/UXデザイナーの劉です。
「デザインシステムはあるのに、同じ機能がアプリごとに違う部品になっている」。複数のチーム・複数のデザイナーで同時に育てているプロダクトでは、かなりの確率で起きることです。
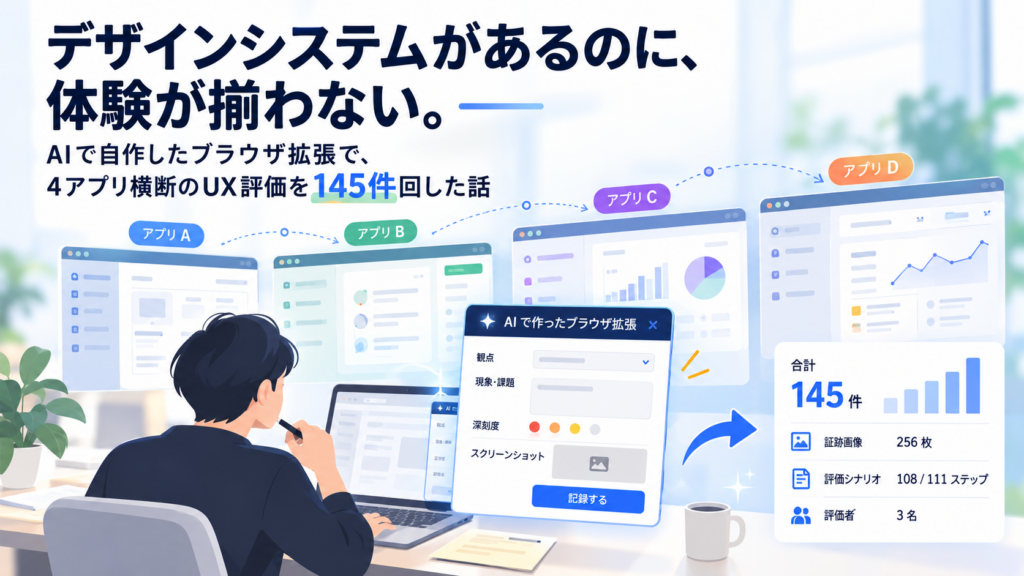
あるクライアントの、複数のアプリで構成されるサービスのUX評価をご一緒するなかで、私たちはこの課題に向き合いました。難しかったのは評価そのものよりも、評価を「回し続けられる状態」をつくること。そこでAI(Claude)とブラウザ拡張機能を自作し、記録・集計・レポート出力をまるごと画面の中に持ち込みました。この記事では、その過程と結果を共有します。
「4つのアプリ」ではなく「1つのサービス」として見る
本サービスは、ポータルを入口に複数のアプリが並ぶ構成です。今回の評価対象は次の4つでした。
- アプリA:コンテンツの作成と共同作業(管理者・利用者)
- アプリB:利用者ごとの個人ワーク(旧版と新版が並存)
- アプリC:コンテンツの配信と、結果の回収・集計・返却
- アプリD:利用データの可視化と振り返り(管理者用・利用者用)
ポイントは、管理者も利用者もこれらを「別々のアプリ」として使っていないことです。ひとつの業務の流れのなかで、コンテンツを配信し、個人ワークを割り当て、結果をダッシュボードで確認する。体験は連続しているので、つまずきはアプリの“境界”に集中します。
なぜ、共通デザインシステムがあっても体験が揃わないのか?
本サービスのデザインシステムは、サービス共通のルールと、アプリごとのルールの2階建てです。共通部分はきちんと効いていて、たとえばカテゴリバッジの色は、アプリA・アプリC・アプリBの新版の3アプリで実測値まで一致していました。
一方で、アプリごとに担当チームもデザイナーも違うため、共通ルールの解釈や適用のタイミングにズレが生まれます。その結果、「同じ機能なのに違う部品」「同じ概念なのに違う言葉」が少しずつ積み上がっていきます。
いちばん分かりやすいのがヘッダーです。ポータルと4アプリのヘッダーを並べると、右端のお知らせ・通知・アカウント・ヘルプ・設定・ホームの構成と順序が、5画面すべて違っていました。
ほかにも、次のような不一致が見つかりました。
- 「対象グループを選ぶ」UIが6通り(チェックボックス表、モーダル、別画面、ドロップダウンなど)
- 利用者を指す呼び方が3通り混在(1画面に3つとも出る画面も)
- 「戻る」操作が左上と右上に分かれ、ラベルも2種類ある
- カテゴリの分け方が9項目と5項目で合わず、カテゴリ別の集計が成り立たない
- 同じ利用者の同じ設定項目を、2つのアプリで別々に変更できる
見た目のばらつきは「気になる」で済みますが、最後の2つは概念モデルの不一致です。見た目をそろえるだけでは解けず、共有のデータモデルや用語辞書のレベルで決める必要があります。この切り分けを示せることが、評価の価値だと考えました。
評価の枠組みは完璧。でも、手で回すのが重かった
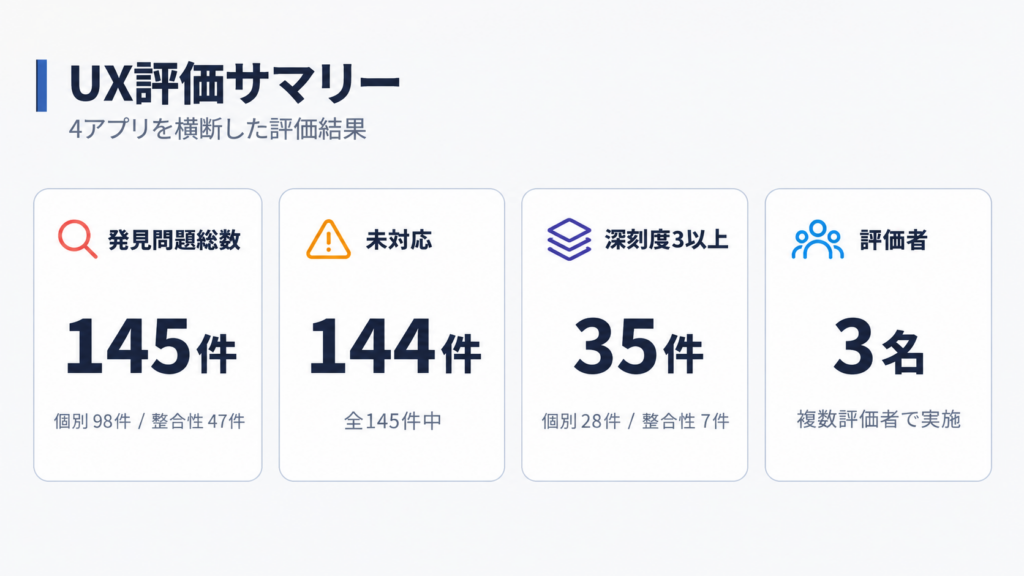
ご依頼は「ヒューリスティック評価を実施したい」というもので、評価の枠組みはすでにクライアント側でしっかり設計されていました。いただいたのは11シート構成のスプレッドシートで、骨格は次の2層評価です。
- (A) 個別アプリ評価:Nielsenの10原則で各アプリ単体を点検
- (B) サービス整合性評価:視覚・インタラクション・言語・情報構造・概念モデル・遷移・認証・ブランドの8つの観点で、複数アプリを比較
深刻度のスケール、優先度スコアの計算式、アプリ別のシナリオ、サービス固有の観点18項目まで定義されていて、そのまま使える完成度でした。
ただ、入力シートは1行25列。評価者は「画面を触る → スクショを撮って名前を付けて貼る → シートで25列を埋める → 画面に戻る」を繰り返します。最終的な記録は145件、証跡画像は256枚。単純計算で3,600セル以上の手入力です。
そして実際に困ったのは、入力量よりもその副作用でした。
- 評価者3名が、同じ現象を別の粒度・別の言葉で記録してしまう
- 「pager」「ページネーション」のように、同じ不一致が別項目になる
- 分類の付け間違いが集計を歪める
- 画面から離れる時間が長く、評価の思考が途切れる
評価シートをそのまま仕様にして、拡張機能をつくる
そこで、評価対象の画面を離れずに記録できるブラウザ拡張機能を、Claudeと一緒に自作しました。
工夫したのは、仕様書を新しく書かなかったことです。クライアントの評価シート(列の定義、選択肢、深刻度スケール、計算式、シナリオ一覧)をそのまま仕様として読み込ませ、入力画面に落とし込みました。だから出力は、シートの構造と1対1で対応します。
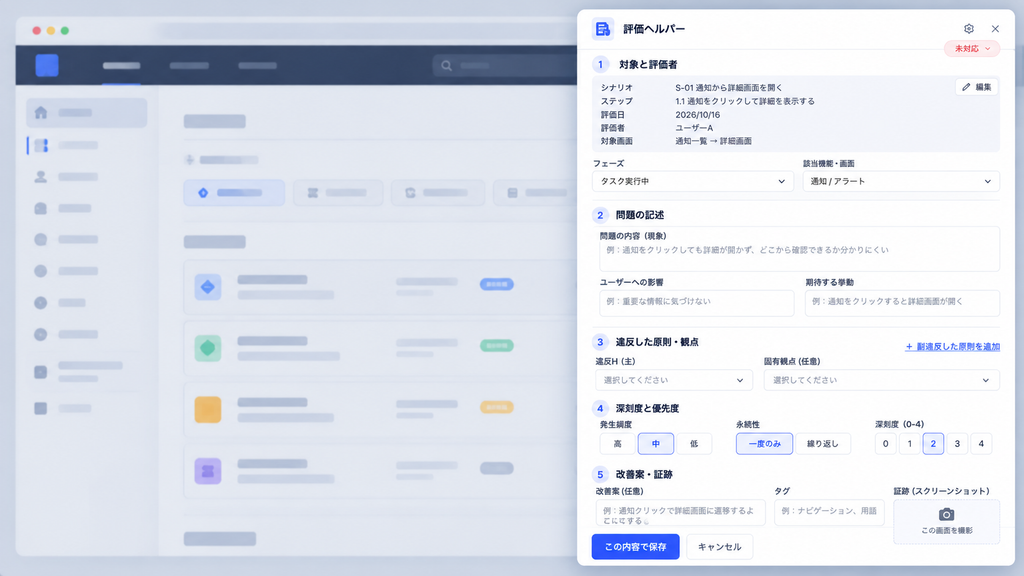
主な機能は次のとおりです。
- 画面上の入力パネル:評価中のタブを離れずに、その場で1件を記録
- スクショの自動紐付け:ボタン1つで撮影・連番付け・添付まで完了
- 語彙の固定:アプリ・観点・深刻度などをすべて選択式にして、表記ゆれと分類ミスを防ぐ
- 優先度の自動計算:入力と同時にスコアとP0〜P4を算出
- シナリオ進捗の管理:タスク単位でチェック。今回は111ステップ中108ステップを完了
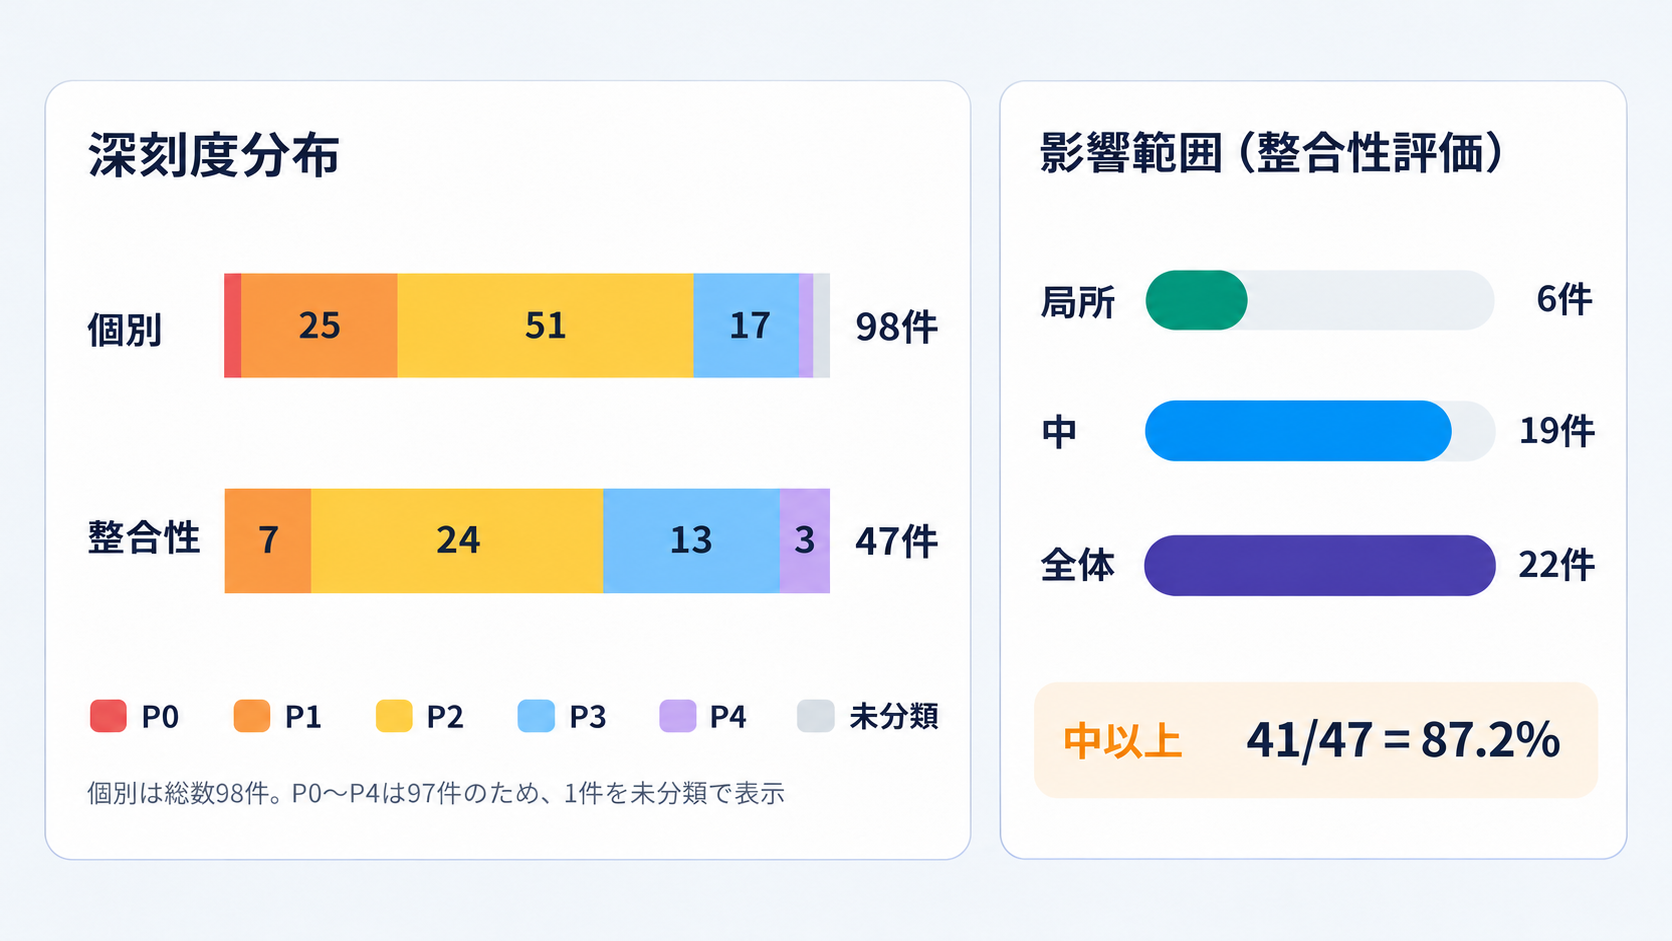
- 複数評価者の統合:記録をJSONで書き出して合流し、重複を突き合わせて1件にまとめる(整合性評価は60件→47件に)
やってみて一番大きかったのは、往復がなくなったことよりも、記録の質が上がったことでした。選択式で言葉がそろうと、評価者は「どう書くか」ではなく「何が起きているか」に集中できます。重複を13件まとめられたのも、記録が構造化されていて機械的に突き合わせられたからです。
レポートは「書く」から「出力する」へ
記録が構造化されていれば、レポートは書くものではなく、出力するものになります。クライアントのシート形式(25列)にも、報告用のサマリにも、同じデータから生成できます。
| 手作業だと起きること | 自動出力にすると |
|---|---|
| 集計のたびにシートを整え直す | 深刻度別・観点別・アプリ別の集計が常に最新 |
| レポート作成時に証跡を探し直す | 256枚の証跡が記録に紐付いたまま出力(リンク切れ0件) |
| 数字と本文が食い違う | 件数や比率がデータから生成されるので、突き合わせ不要 |
| 評価者ごとの差が見えない | 評価者別の発見数から、評価の網羅性を点検できる |
「同じフォーマットで何度でも出せる」ことは、見た目以上に意味があります。評価を1回きりのイベントではなく、リリースごとに回せるプロセスにできるからです。
見えてきたこと:揃えられる証拠と、3つの優先課題
評価は「ダメ出し」ではありません。うまくいっている部分を確かめることも同じくらい大切です。今回いちばん価値があったのは、新しいデザインシステムへの移行が実際に効いていると実測で確認できたことでした。
アプリBの新版とアプリCは、新しいデザインシステムに素直に準拠していました。つまり「揃えられる」ことはすでに証明されていて、課題は残りのアプリをどう寄せるかに絞れます。
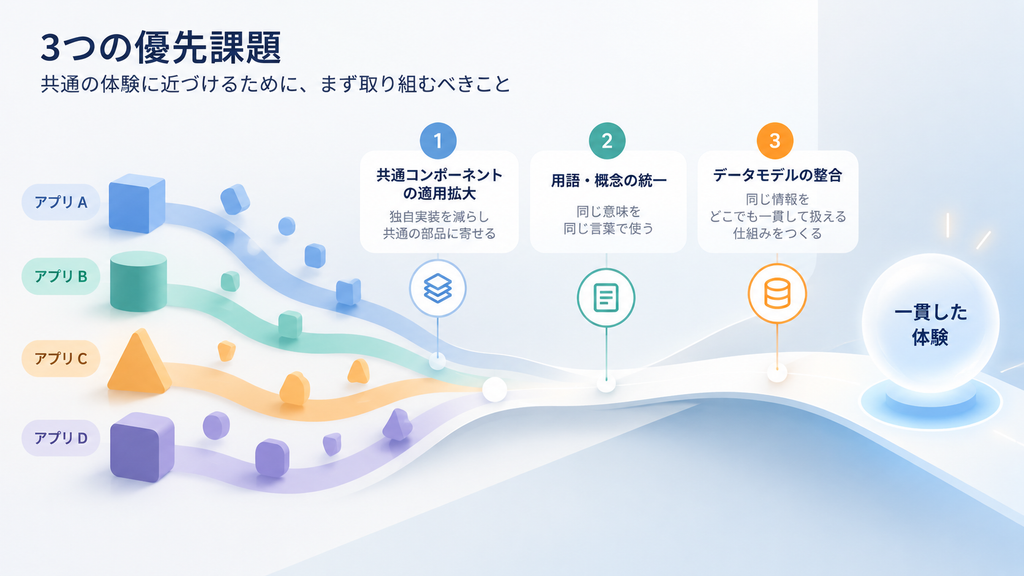
そこから導いた優先課題は、次の3つです。
- 共通ヘッダーをつくる:ロゴ(ポータルへの戻り)、組織名・ユーザー名、対象期間、ヘルプ、通知、アカウントを1つの部品にまとめる。8つの観点のうち5つの主な指摘がまとめて解消します
- 残りのアプリを新デザインシステムに寄せる:カテゴリ色、「戻る」、ページャの統一など。他アプリで既にできていることを適用するだけなので、コストに対して効果が大きい
- 共有データモデルと用語辞書を決める:グループ・カテゴリ・期間・利用者ごとの設定など。見た目の統一では解けない不一致は、ここでしか解けません
また、途中で自分たちの仮説が外れたことも記録に残しています。「カテゴリの色分けが4アプリで4通り」という指摘は、全要素のスタイルを実測したところ3アプリで一致しており、誤りでした。深刻度を下げ、訂正の経緯も残しています。こうした修正を痛みなくできるのも、記録が構造化されているからです。
まとめ:評価を「イベント」から「プロセス」へ
今回うまくいった一番の理由は、評価の枠組みがクライアント側にあり、それをそのまま仕様にできたことでした。クライアントが「何を評価するか」を設計し、私たちが「それを回し続けられる形」にする。そんな役割分担で、一緒に組み立てた仕組みです。
- 共通デザインシステムがあっても、担当が分かれると「同じ機能・違う部品」は必ず生まれる
- 評価の枠組みがしっかりしているほど、手作業での運用は破綻しやすい
- AIを使えば、評価シートそのものを仕様にして、その現場専用のツールを短期間でつくれる
- 記録が構造化されていれば、集計・統合・レポート・訂正のすべてが安くなる
複数プロダクトをまたぐUXの整合性や、デザインシステムの運用、AIを使った業務ツールづくりに興味があれば、ぜひお気軽にご相談ください。